En quinze ans d’API Management, on n’a jamais accepté qu’un client applique lui-même les règles. En agentique, c’est pourtant exactement ce qu’on fait — sauf que le client a la capacité de décider seul de ce qu’il appelle, à partir de contenus qui n’ont pas nécessairement été validés.
Même si la couche protocolaire se standardise et que l’interopérabilité progresse, un agent mieux connecté n’est pas pour autant un agent mieux encadré. MCP relie un agent à ses outils, A2A fait dialoguer les agents entre eux : ces protocoles décrivent comment deux composants communiquent. Ils ne disent rien des actions permises, des ressources concernées, ni de la personne pour le compte de laquelle l’agent agit. Ces règles doivent donc être appliquées ailleurs.
Mais où, précisément ? Le précédent article, Vos IA passent à l’action. Êtes-vous certain de pouvoir les contrôler ?, posait qu’un agent peut prendre toute l’autonomie qu’on lui laisse, et que les garde-fous doivent donc vivre là où il ne peut ni les ignorer ni les désactiver. Il se terminait par une promesse : décrire à quoi ressemble concrètement ce dispositif.
Cette série tient la promesse, en cinq volets. Celui-ci pose le cadre : un cas d’usage, l’architecture « naïve » qu’on construirait spontanément, la règle qui dit où placer les contrôles, et une vue d’ensemble en trois plans. Les trois suivants détailleront chacun de ces plans. Le dernier parlera de mise en œuvre.
Le cas d’usage : l’arrivée d’un collaborateur
Pour juger une architecture, il faut un cas concret : assez simple pour tenir sur un schéma, assez riche pour éprouver chaque exigence. L’arrivée d’un nouveau collaborateur fait l’affaire.
Tout le monde connaît le scénario. Une embauche est confirmée dans le SIRH. Il faut ouvrir les comptes, attribuer les droits du poste, commander et configurer un portable, préparer le dossier administratif — et que tout soit prêt le jour J. Aujourd’hui : une douzaine de tickets, trois ou quatre équipes, beaucoup de relances.
Confié à des agents, ce processus concentre presque toutes les difficultés que l’on cherche à maîtriser :
- Il traverse plusieurs domaines, possédés par des équipes différentes : les RH, l’IT, et parfois les services généraux.
- Il sort de l’entreprise : le poste de travail est commandé à un fournisseur, qui peut lui-même exposer son propre agent.
- Il démarre sur un événement — l’embauche confirmée — et non sur une question posée à un assistant.
- Il manipule des données personnelles : identité, contrat, rémunération.
- Il accorde des droits, dont certains privilégiés, sur des systèmes sensibles.
- Il dure : plusieurs jours, voire plusieurs semaines, entre la signature et l’arrivée. L’état du dossier doit être conservé, et le processus doit pouvoir être interrompu et repris.
Le blueprint « naïf »
Les guides publiés par les laboratoires d’IA décrivent tous, sous des noms différents, le même schéma de base. Anthropic parle d’orchestrateur et d’exécutants : un agent principal décompose la tâche, la délègue à des agents spécialisés, puis en fait la synthèse. OpenAI parle de « manager » : un agent central qui appelle d’autres agents comme il appellerait des outils. C’est ce schéma, appliqué à notre cas, que la plupart des équipes construiraient spontanément.
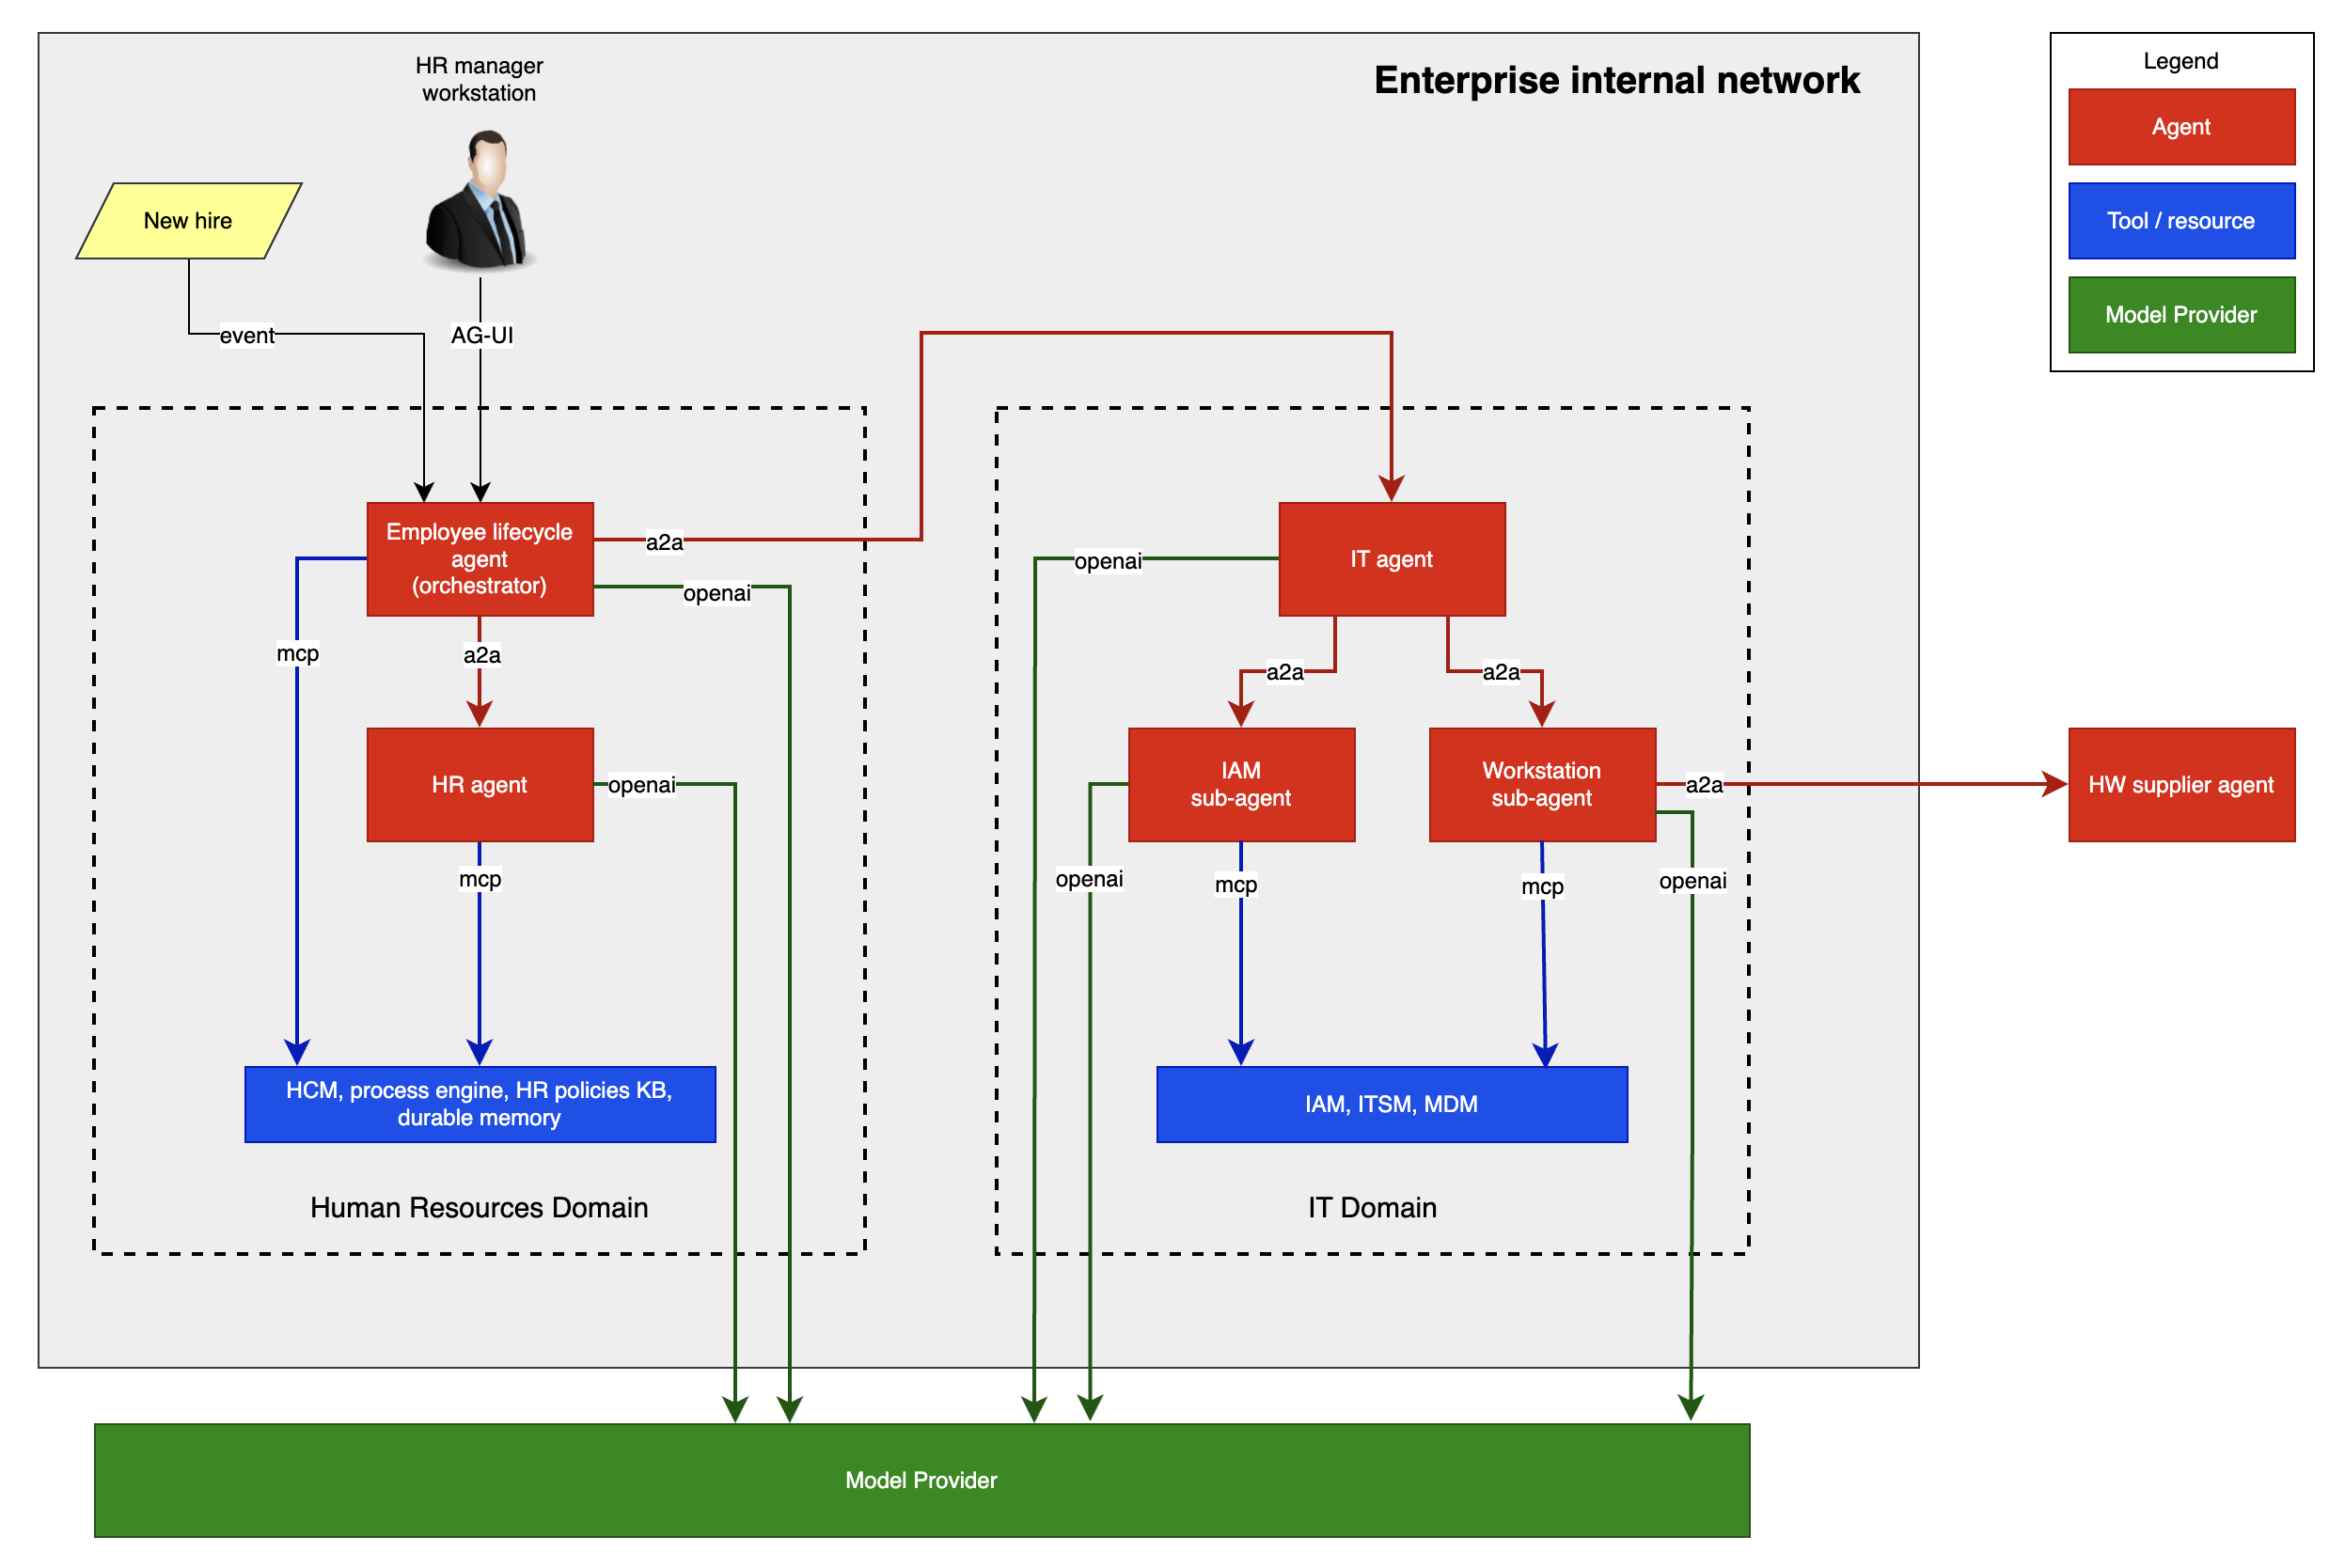
Figure 1 — Le blueprint tel qu’on le dessine spontanément : qui parle à qui, et avec quel protocole.
Chaque brique a sa raison d’être :
- L’agent de cycle de vie du collaborateur, porté par le domaine RH, pilote le processus de bout en bout — arrivée, mobilité, départ. Il ne fait presque rien lui-même : il planifie, délègue, suit l’avancement.
- Les agents de domaine — RH, IT — portent l’expertise métier. L’agent IT délègue lui-même à des sous-agents spécialisés : l’un pour les comptes et les accès, l’autre pour le poste de travail — dotation selon le poste, réservation dans le parc ou commande, enrôlement et configuration, organisation de la remise.
- L’agent du fournisseur reçoit du sous-agent « poste de travail » la commande du matériel, et en suit la livraison. Il n’appartient pas à l’entreprise.
- Les modèles sont consommés chez un fournisseur, hors du réseau de l’entreprise, et pas nécessairement les mêmes partout : un modèle puissant pour planifier, des modèles plus légers et moins coûteux pour les tâches spécialisées.
- La mémoire durable conserve le contexte du dossier sur toute sa durée : ce qui a été constaté, ce qui a été décidé, ce qui reste en attente. Elle ne porte pas pour autant l’état d’exécution du processus — un onboarding qui dure trois semaines réclame un état autoritatif, des appels idempotents et des points de reprise, donc un moteur de processus, pas un magasin de souvenirs interrogé par un modèle. Elle se distingue du contexte de travail de chaque agent, interne et éphémère, qui n’apparaît pas sur le schéma comme un composant autonome.
- La base de connaissances donne accès aux politiques RH : grilles de droits par poste, règles d’équipement, procédures.
- Les skills sont des procédures métier empaquetées — « onboarding d’un cadre », « checklist sécurité pour un accès privilégié ». Dans le modèle retenu ici, elles ne sont pas appelées comme un service : l’agent les charge dans son contexte quand il en a besoin.
- Les outils, exposés via MCP, donnent accès aux ressources de chaque domaine : le SIRH — le HCM du schéma —, le moteur de processus, la base de politiques et la mémoire durable côté RH ; l’IAM, l’ITSM et la gestion des terminaux (MDM) côté IT.
Trois protocoles spécialisés structurent le schéma : MCP pour les outils et les ressources, A2A pour la délégation entre agents, AG-UI pour le dialogue entre un agent et l’interface de son utilisateur. Pour l’accès aux modèles, il n’existe pas d’équivalent : les APIs compatibles OpenAI jouent le rôle d’interface de fait, sans constituer un standard comparable.
Ce schéma a des qualités réelles. Il est modulaire : chaque agent a un périmètre clair et un contexte réduit. Il repose sur des protocoles standard. Il est lisible. Il montre bien qui parle à qui.
Mais il ne montre jamais à quelles conditions. Chaque flèche du schéma est une relation de confiance directe, sans rien entre les deux extrémités. Posons quelques questions simples :
- Quand le sous-agent « comptes et accès » crée un compte administrateur, au nom de qui agit-il ? Du manager RH qui a déclenché le processus, de l’agent IT, de l’orchestrateur ?
- Qui décide qu’un droit privilégié peut être accordé sans validation humaine, et qu’un autre ne le peut pas ?
- L’agent du fournisseur annonce savoir « commander du matériel ». Qu’est-ce qui l’empêche de demander aussi l’adresse personnelle du collaborateur, sa date de naissance, ou autre chose encore ?
- La base de connaissances renvoie-t-elle les mêmes documents à un agent qui travaille pour un stagiaire et à un agent qui travaille pour le DRH ?
- Qui peut écrire dans la mémoire du dossier ? Un document empoisonné lu par l’agent RH peut-il y laisser une instruction qui ressurgira trois jours plus tard ?
- Si l’agent IT entre en boucle et consomme en une nuit le budget d’inférence du mois, qui s’en aperçoit, et qui l’arrête ?
Dans ce schéma, la réponse est toujours la même : c’est à l’agent de s’en charger. Dans son prompt, ou dans le code qui l’exécute. C’est précisément la réponse que l’article précédent excluait.
Les guides des laboratoires ne sont pas en cause : ils décrivent comment construire un agent, pas comment l’insérer dans un système d’information. Et les grandes plateformes cloud ont, depuis, intégré à leurs offres des passerelles, des identités d’agents et des moteurs de politiques. Le constat n’est donc pas que le sujet est ignoré, mais que le schéma de base, celui qu’on dessine en premier, le laisse hors champ.
La règle d’interposition
Le principe est acquis : le contrôle ne peut pas résider à l’intérieur de ce qu’il contrôle. Il doit s’interposer, à l’extérieur de l’agent, sur le chemin de ses échanges. Reste à savoir où.
Pas partout. Interposer un point de contrôle sur chaque échange, y compris entre un agent et ses propres sous-agents, multiplierait la latence, la complexité et les points de défaillance, sans gain de sécurité proportionnel. Les architectures microservices ont déjà vécu ce débat. Et le protocole ne décide de rien : deux agents peuvent dialoguer en A2A sans que rien ne s’interpose entre eux — c’est exactement ce que montre la figure 1.
La règle proposée ici est simple : on interpose à chaque franchissement d’une frontière de confiance, de propriété ou de privilège. La troisième est la plus souvent oubliée : deux composants d’une même équipe peuvent manipuler des pouvoirs sans commune mesure.
Appliquée à notre cas, elle fait apparaître sept frontières :
- Entre l’utilisateur ou l’événement et l’agent : qui déclenche, avec quels droits ?
- Entre un agent et les modèles : un fournisseur externe, des données qui sortent, un coût qui court.
- Entre deux domaines : l’orchestrateur RH qui sollicite l’agent IT franchit une frontière d’organisation.
- Entre l’entreprise et un tiers : l’agent du fournisseur est hors du périmètre de confiance. Et c’est un sous-agent, au bout d’une chaîne qui part du manager RH et passe par l’orchestrateur puis l’agent IT, qui franchit cette frontière : une flèche en apparence interne peut sortir de l’entreprise.
- Entre un agent et les systèmes de l’entreprise : chaque outil ouvre un accès au SIRH, à l’IAM, à l’ITSM.
- Entre un agent et les données qu’il lit ou écrit durablement : mémoire durable, base de connaissances.
- Entre un agent et le reste du monde : toute destination réseau qui n’a pas été explicitement autorisée.
À l’inverse, à l’intérieur d’un domaine, tant qu’ils ne franchissent aucune frontière de privilège ou de sensibilité, les échanges peuvent rester directs. L’agent IT et ses deux sous-agents appartiennent à la même équipe, suivent le même cycle de livraison, partagent le même périmètre de responsabilité. Leur couplage peut être fort : c’est l’affaire du domaine.
On retrouve le principe des contextes délimités qui a structuré la décomposition des applications en services : couplage fort à l’intérieur d’une frontière, couplage faible et contractuel entre les frontières. On retrouve aussi une forme de fédéralisme : les domaines restent maîtres de leur organisation interne, mais leurs frontières sont gouvernées selon des règles communes.
Un domaine peut aussi consommer directement les outils qu’un autre publie, quand l’opération est déterministe et qu’y intercaler un agent n’apporterait rien. La règle ne change pas : on passe par la passerelle du domaine appelé, et jamais par ses outils internes.
Cette règle a une limite qu’il faut assumer. L’interposition suppose un échange observable, en pratique un saut réseau. Le contexte de travail d’un agent, ou un sous-agent qui s’exécute dans le même processus que celui qui l’appelle, échappent à tout point de contrôle externe. Dans le modèle retenu ici, une skill n’est pas appelée non plus : elle est chargée dans le contexte de l’agent, et aucune passerelle ne la voit passer — sa gouvernance se joue au moment de sa distribution, pas de son usage.
Le schéma illustre ce point par défaut : le sous-agent chargé des comptes et des accès manipule les pouvoirs les plus élevés de tout le dispositif, et reste pourtant appelé directement par l’agent IT, comme son voisin qui commande du matériel. C’est le point de départ le plus fréquent, et le premier candidat à sa propre porte — le troisième volet y reviendra.
Il en découle une conséquence d’architecture : la frontière d’interposition devient un critère de découpage. Si un sous-agent doit être contrôlé indépendamment de son agent parent — parce qu’il manipule des droits privilégiés, par exemple —, il doit être déployé comme un agent à part entière, derrière la frontière. C’est la même logique que la segmentation réseau : on ne décide pas seulement de ce qui communique, mais de ce qui doit être séparé pour pouvoir être contrôlé.
Deux familles d’interposition
La règle dit où interposer. Elle ne dit pas comment. Deux familles de réponses coexistent.
L’interposition synchrone est celle de l’API Management : une passerelle placée entre l’appelant et l’appelé, qui reçoit chaque requête, l’évalue, et la laisse passer ou la bloque. C’est le modèle naturel des appels d’outils via MCP, des délégations entre agents via A2A, des appels aux modèles. Sa force : l’évaluation se fait requête par requête, sur son contenu, y compris ses arguments.
L’interposition asynchrone repose sur un broker de messages. Les agents ne s’appellent plus directement : ils publient des événements et s’abonnent à ceux qui les concernent. Notre cas s’y prête bien : il démarre sur un événement, il s’étale dans le temps, et l’avis d’expédition du fournisseur n’a aucune raison d’être attendu par un agent bloqué en ligne. Des approches comme Solace Agent Mesh transportent déjà les échanges A2A sur un broker d’événements, et l’écosystème Kafka suit la même pente. Le broker apporte ce que l’appel synchrone ne sait pas bien faire : découplage temporel, résilience face aux indisponibilités, absorption des pics, rejeu, diffusion vers plusieurs consommateurs.
Il ne couvre pas tout pour autant. Son contrôle d’accès porte sur les canaux, pas sur le contenu : il autorise un agent à publier des demandes de création de compte, mais ne sait pas refuser celle qui vise un compte administrateur. Il ne fournit pas non plus de sémantique métier — la livraison et l’ordre sont garantis, l’idempotence et la machine d’état restent à la charge de l’agent. L’inspection des contenus et la validation humaine, enfin, sont hors de son périmètre.
Les deux familles ne sont donc pas concurrentes. Elles répondent au même principe avec des mécanismes différents, et convergent déjà : des passerelles savent aujourd’hui gouverner des flux d’événements, et des brokers transportent des protocoles d’agents. Cette série se concentre sur l’interposition synchrone, parce que c’est là que se joue l’autorisation fine des actions. La voie asynchrone a ses propres équivalents dans les trois plans qui suivent — catalogue d’événements et de schémas, droits par sujet de publication, traçabilité des messages. Les principes sont les mêmes ; les outils diffèrent.
Trois plans pour organiser l’interposition
Une fois les frontières identifiées, il faut organiser ce qui s’y passe. Le cadre le plus éprouvé vient, là encore, de l’API Management — et avant lui des réseaux : la séparation en trois plans.
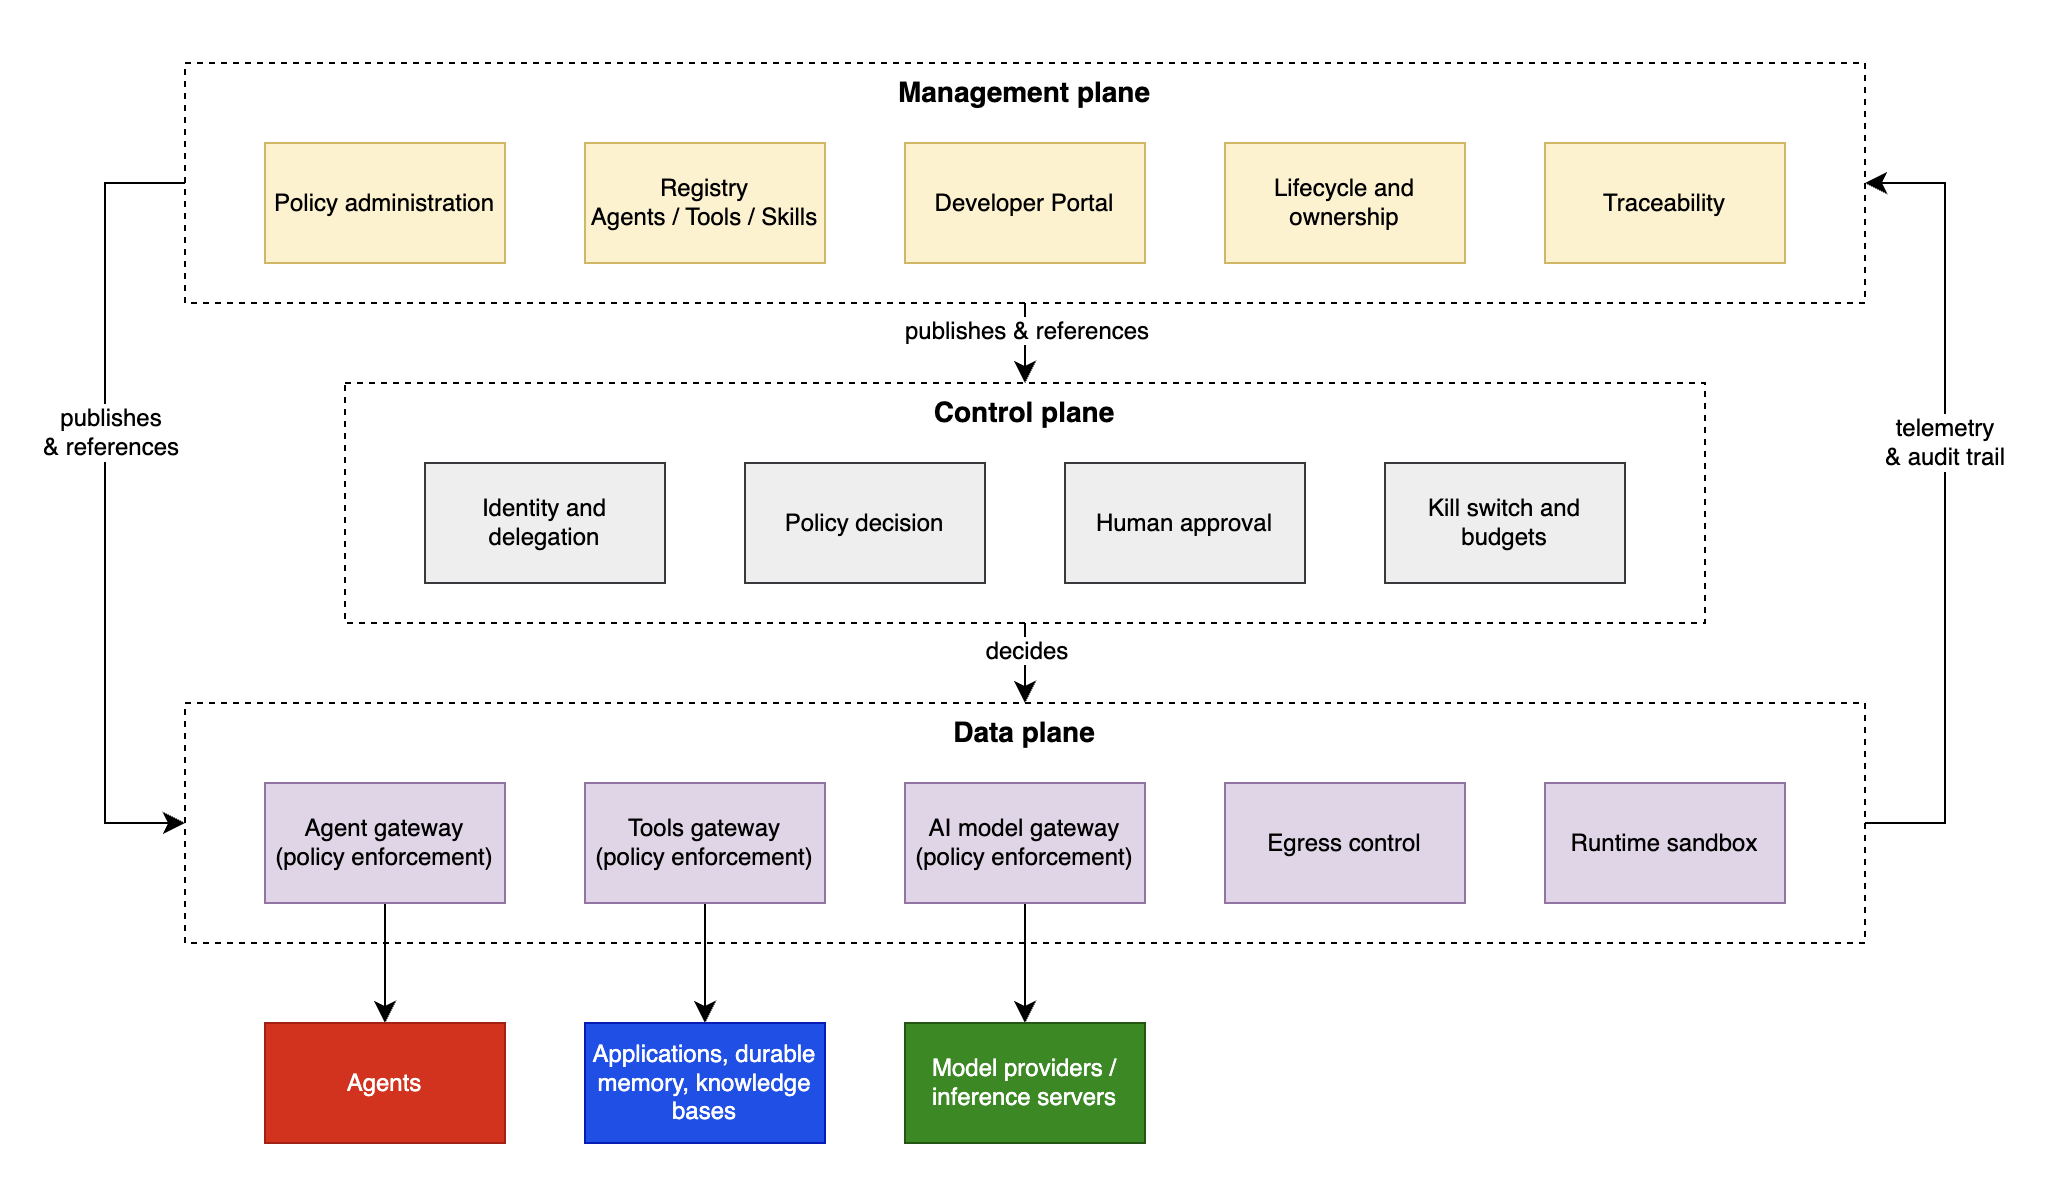
Figure 2 — Les trois plans. Les règles descendent, la preuve remonte. Chaque bande fait l’objet d’un article de la série.
Le plan de données est celui où circulent les échanges et où les décisions sont appliquées. On y trouve les points d’interposition eux-mêmes, un par type de frontière : une passerelle pour les échanges entre agents, une pour les appels d’outils — qui expose les APIs existantes comme des outils consommables, sans réécrire les systèmes sous-jacents, même si la conception des outils eux-mêmes reste un vrai travail —, une pour les appels aux modèles, et les dispositifs de confinement : contrôle des sorties réseau et bac à sable d’exécution.
Le plan de contrôle est celui où les décisions sont prises. Il porte l’identité propre de chaque agent et la chaîne de délégation qui relie chaque action à celui qui l’a initiée, le moteur qui évalue les politiques de façon déterministe, le circuit d’approbation humaine, et les disjoncteurs : kill switch et plafonds de consommation.
Le plan de gestion est celui où l’on sait ce qui existe et à qui cela appartient. Il porte l’administration des politiques, le registre des agents, outils et skills approuvés, le portail qui permet aux concepteurs de les découvrir, le cycle de vie qui encadre leur publication et leur retrait, et la traçabilité qui permet de reconstituer après coup ce qui s’est passé.
Ceux qui viennent du contrôle d’accès reconnaîtront le découpage de XACML : les passerelles sont les points d’application (PEP), le plan de contrôle porte le point de décision (PDP) et les attributs qu’il consulte (PIP), le plan de gestion le point d’administration des politiques (PAP). Ce découpage est logique : dans les faits, le PDP est souvent embarqué dans la passerelle. L’essentiel est que les règles, elles, soient écrites une seule fois, dans le plan de gestion.
Cette séparation n’est pas une commodité de présentation. Elle a trois conséquences d’architecture.
Chaque plan évolue à son rythme. Une politique peut être modifiée sans redéployer les passerelles. Une passerelle peut être ajoutée sans réécrire les politiques. Un agent peut être retiré du registre sans toucher au reste.
Chaque plan a ses exigences propres.
- Le plan de données doit être rapide et résilient : il est sur le chemin de chaque requête.
- Le plan de gestion travaille à l’échelle humaine : publication, revue, approbation.
- Le plan de contrôle est à cheval. Une partie se pousse en configuration, mais l’identité, la délégation et la décision d’autorisation se rendent appel par appel : elles sont donc, elles aussi, sur le chemin critique, et appellent les mêmes exigences que le plan de données — latence bornée, haute disponibilité, jetons et décisions mis en cache, moteur de décision au plus près du point d’application.
Chaque interface entre les plans peut s’appuyer sur un standard.
- MCP et A2A dans le plan de données ;
- OAuth et l’échange de jetons pour la délégation ;
- les conventions OpenTelemetry, encore en cours de standardisation pour l’IA générative, pour la traçabilité.
C’est ce qui rend l’ensemble modulaire, et ce qui permettra, le moment venu, d’en remplacer une brique sans remplacer les autres.
Le plan de données, posé sur le cas
Reprenons la figure 1, et plaçons-y les points d’interposition. Rien ne bouge : mêmes agents, mêmes ressources, mêmes protocoles. On ajoute seulement ce qui manquait.
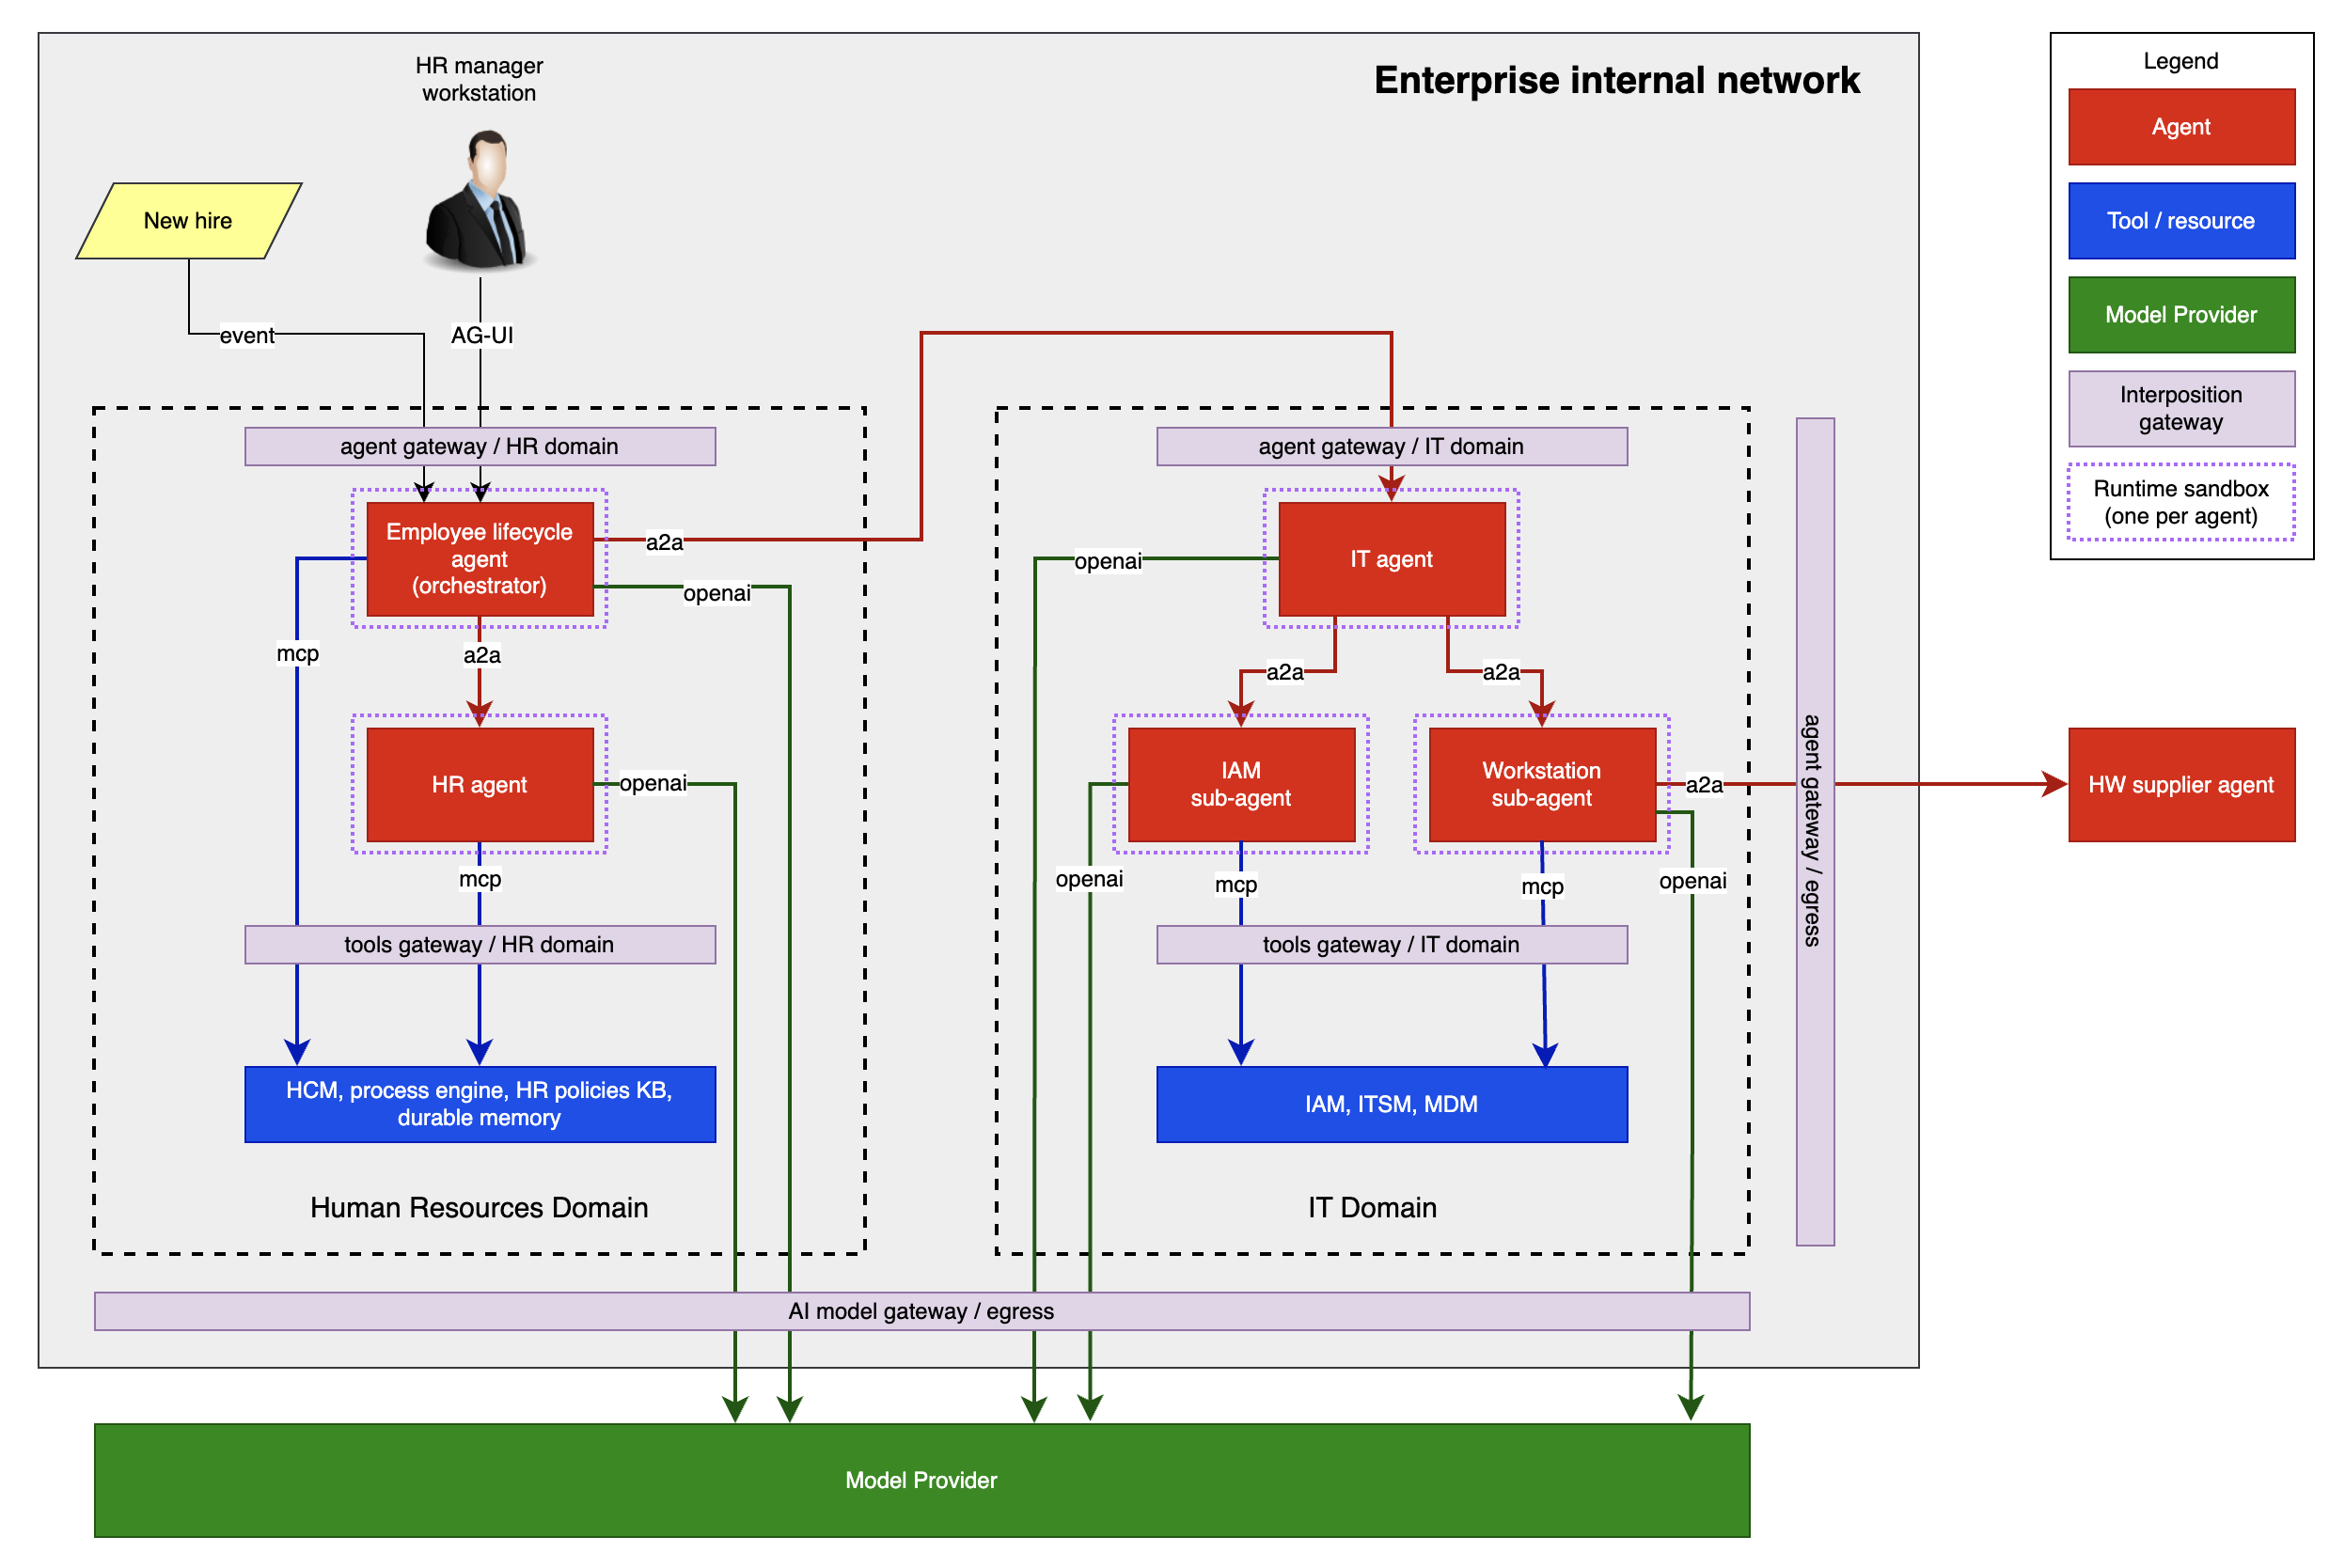
Figure 3 — Le plan de données appliqué au cas. Les passerelles contrôlent les échanges aux frontières ; les contours violets matérialisent l’isolation du runtime de chaque agent interne.
Cinq familles de points d’interposition suffisent à couvrir les sept frontières, parce que plusieurs d’entre elles aboutissent au même endroit. Chacune se décline ensuite en autant d’instances que nécessaire — les passerelles d’agents entrantes et les passerelles d’outils étant déployées par domaine :
- Une passerelle d’agents par domaine, qui reçoit tout ce qui entre, qu’il s’agisse d’un humain, d’un événement ou d’un autre domaine. L’événement du SIRH et l’accès du manager côté RH, la délégation de l’agent de cycle de vie côté IT. Une porte, quel que soit le nombre d’appelants.
- Une passerelle d’agents en sortie, à la frontière de l’entreprise, que franchit l’appel au fournisseur. Elle ne protège pas le tiers, il ne nous appartient pas, mais ce qu’on lui transmet et ce qu’on accepte de lui.
- Une passerelle d’outils par domaine, devant tout ce que le domaine expose aux agents : ses applications, sa base de connaissances, sa mémoire durable, et le moteur qui porte l’état du processus. C’est elle qui transforme les APIs existantes en outils, opération par opération. L’état d’un onboarding devient ainsi une ressource comme une autre. Le moteur expose des opérations métier — consulter l’état, demander une transition. L’agent demande la transition, le plan de contrôle l’autorise, puis le moteur en vérifie la validité métier et l’applique.
- Une passerelle de modèles, partagée, parce que ce qu’on y contrôle, coût, quotas, garde-fous de contenu, choix du fournisseur, est transverse par nature.
- Le contrôle des sorties réseau et le bac à sable d’exécution ferment la dernière frontière, celle qui n’a pas de passerelle attitrée : tout ce que l’agent pourrait atteindre en dehors des chemins prévus. Sur la figure, chaque agent interne s’exécute dans son propre environnement isolé — c’est ce que matérialisent les contours en pointillés. Le contrôle d’egress générique n’apparaît pas comme une passerelle supplémentaire : les politiques réseau attachées à ces environnements refusent par défaut toute sortie qui ne passe pas par la passerelle de modèles ou par celle des agents externes.
Ce que la figure ne montre pas encore : qui décide, et qui sait. Les barres appliquent des règles qu’elles n’écrivent pas, et rendent compte à un plan de gestion qui n’est pas dessiné. C’est l’objet des volets suivants.
Dans le modèle retenu ici, l’usage d’une skill fait exception : une fois distribuée, son chargement dans le contexte ne déclenche l’appel d’aucune capacité externe. Son contrôle se joue donc au moment de sa distribution — registre approuvé, version figée, signature vérifiable —, et sa récupération initiale, quand elle est distante, reste un échange gouverné comme les autres. Cela relève du plan de gestion, pas du plan de données.
Ce qui vient
Chacune des exigences posées dans l’article précédent trouve sa place dans l’un de ces plans. Les trois prochains volets les reprendront, un plan par volet :
- Volet 2 — le plan de données : par où passent les échanges. Les passerelles qui exposent le patrimoine existant aux agents, opération par opération, sur les protocoles du marché ; l’interface unique vers les modèles, avec ses garde-fous de contenu et la protection des données personnelles ; le confinement de l’exécution et des sorties réseau.
- Volet 3 — le plan de contrôle : qui a le droit de faire quoi. L’identité propre de chaque agent et la délégation qui le relie à l’initiateur ; une autorisation rendue sur l’opération, la ressource et les arguments, y compris entre agents, capacité par capacité ; la mise en attente pour décision humaine au-delà d’un seuil ; le kill switch, les fusibles budgétaires et la compensation des actions interrompues.
- Volet 4 — le plan de gestion : les règles, le patrimoine, la preuve. L’administration des politiques, écrites une seule fois et distribuées à chaque point d’application ; le registre, qui limite la découverte au strict nécessaire ; la chaîne d’approvisionnement, qui vérifie origine, intégrité et version avant usage ; la trace, qui permet de reconstituer le contexte d’une décision jusque dans les systèmes métiers.
La lutte contre l’empoisonnement du contexte et de la mémoire n’apparaît pas dans cette liste : elle ne relève d’aucun plan en particulier, mais de leur combinaison. On y reviendra à chaque volet.
Le cinquième volet quittera l’architecture de référence pour sa mise en œuvre : ce que propose le marché, et pourquoi la couche d’interposition doit rester indépendante des plateformes qu’elle gouverne. Car la couche qui contrôle les agents est aussi celle qui permet d’en changer.